🪟 ThinWindow [Plugin de Claude Code - Agent Skill - Node.js - Benchmarking]
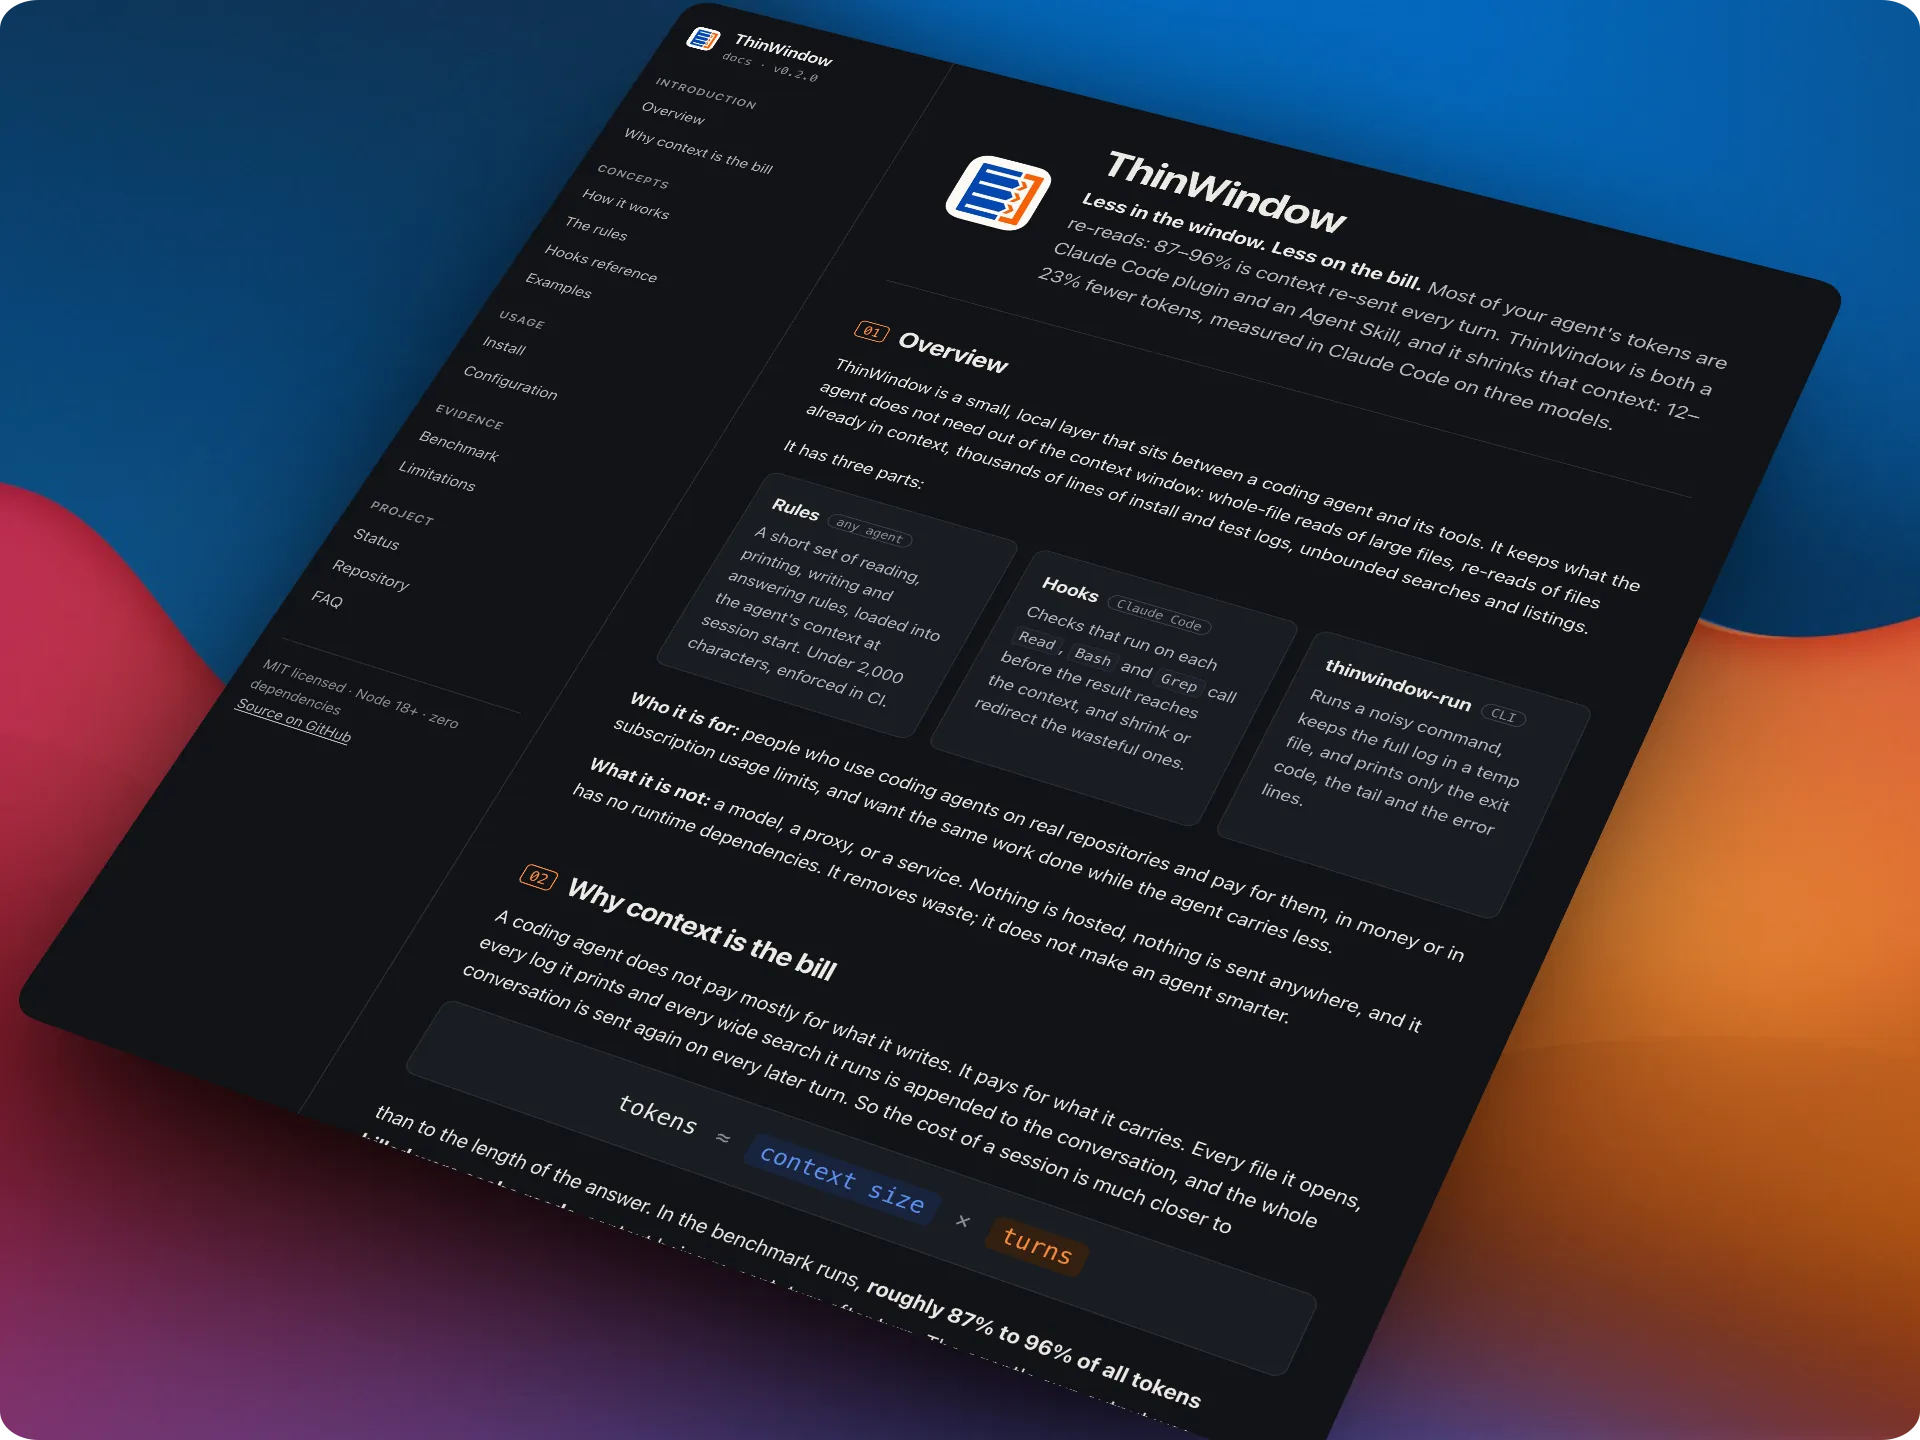
ThinWindow hace que los agentes de código lean menos. Se distribuye a la vez como plugin de Claude Code y como Agent Skill: un conjunto breve de reglas de lectura que se carga al inicio de la sesión, más hooks que hacen cumplir la parte cara de esas reglas en la propia llamada a la herramienta, antes de que un archivo de 2.000 líneas llegue a la ventana de contexto. En 112 corridas de benchmark sobre tres modelos recortó entre un 13% y un 23% del total de tokens, con el mismo éxito en Opus y Sonnet. Sin dependencias, sin telemetría, licencia MIT.
Ver en GitHub DocumentaciónLo que se paga es lo que el agente arrastra, no lo que escribe:
Un agente de código no paga sobre todo por sus respuestas. Paga por su contexto. Cada archivo que abre, cada log de instalación que imprime y cada grep amplio que corre se agrega a la conversación, y la conversación entera se reenvía en cada turno posterior. El costo de una sesión se parece más a
tokens ≈ tamaño del contexto × turnosque al largo de la respuesta. En las corridas base del benchmark, entre el 87% y el 96% de cada token facturado fue una lectura de caché: contexto reenviado, turno tras turno. La salida del propio agente quedó por debajo del 2%.
Esa proporción es todo el argumento. Pedirle al agente que sea breve toca la columna del ~1%. Evitar que se traiga un archivo de 2.000 líneas a la ventana en el turno 3 toca la del ~90%, en ese turno y en todos los que siguen.
Medido sobre repositorios reales y publicado completo:
Cada corrida es un agente resolviendo una tarea desde cero, en un clon nuevo de un repositorio open source real — click o commander.js — fijado a un commit, con las dependencias ya instaladas antes de que el agente arranque, para que los logs de instalación no se le facturen a ninguna de las dos condiciones. La condición base usa Claude Code sin modificar; ThinWindow usa lo mismo más el plugin. No cambia nada más. Una verificación oculta, que el agente nunca ve, decide si la corrida fue exitosa.
Medido, no prometido
3 modelos, 8 tareas, 112 corridas, un agente por corrida, sin descartar ninguna. ThinWindow recortó entre un 13% y un 23% de los tokens totales.
| Modelo | Tokens | Costo | Éxito base → ThinWindow | Corridas |
|---|---|---|---|---|
| Opus 5.5 | −15,8% | −19,4% | 16/16 → 16/16 | 32 |
| Sonnet 5 | −13,2% | −7,9% | 24/24 → 24/24 | 48 |
| Haiku 4.5 | −23,0% | −20,2% | 14/16 → 13/16 | 32 |
Claude Code 2.1.282, medido del 2026-09-25 al 2026-09-26. Se lee directamente de los datos crudos del benchmark.
La tabla de arriba no es una captura ni un número copiado a mano: se lee de los datos del benchmark en el repositorio cada vez que se compila esta página, y otra vez en tu navegador, así que refleja la última corrida publicada y no el día en que escribí este post.
Un skill y un plugin, y por qué hacen falta los dos:
Son dos capas de lo mismo, no dos productos distintos.
-
El Agent Skill es la capa de instrucciones. El
SKILL.mdlleva un archivo de reglas que se mantiene por debajo de los 500 tokens: localizar congrepantes de leer, leer rangos de líneas en lugar de archivos enteros, no releer lo que ya está en contexto, acotar la salida de los comandos, hacer el cambio más chico que funcione y cerrar con tres líneas como máximo. Es portable: cualquier agente compatible con Agent Skills lo instala connpx skills add thinwindow/thinwindow, y los agentes que leenAGENTS.mdpueden pegar las mismas reglas ahí. -
El plugin de Claude Code es la capa que las hace cumplir, y además incluye ese mismo skill. Sobre las reglas, registra hooks que corren en la llamada a la herramienta, antes de que el resultado llegue al contexto: un
Readcompleto de un archivo de más de 400 líneas vuelve como las primeras 120 líneas más un índice numerado; releer un archivo sin cambios que ya está en contexto se rechaza; instalaciones, builds y tests pasan porthinwindow-run, que manda el log completo a un archivo temporal y devuelve el código de salida, el final del log y las líneas de error;catde un lockfile,git logsin-n,ls -R,treesin-Lyfindsin límite reciben una alternativa más barata.
Las reglas las hacen cumplir los hooks en lugar de quedar en manos del modelo, porque una regla que el agente puede olvidar bajo presión no es una regla. Y como los hooks interceptan la llamada en vez de corregir al agente después, hacerlas cumplir no cuesta un turno. Instalar el plugin da las dos capas; instalar solo el skill da la mitad portable.
Todos los hooks fallan en modo abierto: cualquier error dentro de ThinWindow deja pasar la llamada intacta, y repetir una llamada rechazada también la deja pasar, así que el agente nunca puede quedarse trabado. Con THINWINDOW=off se apaga todo.
Instalación:
# Claude Code — reglas y hooks
/plugin marketplace add thinwindow/thinwindow
/plugin install thinwindow@thinwindow

# Cualquier agente con Agent Skills (Codex, Cursor, Copilot, Gemini CLI, OpenCode) — solo las reglas
npx skills add thinwindow/thinwindow
Stack Técnico:
- Runtime: Node.js 18+, ESM, cero dependencias en ejecución. Los hooks son scripts locales que leen una llamada a una herramienta y devuelven una decisión.
- Distribución: un marketplace de plugins de Claude Code, el estándar de Agent Skills y un adaptador
AGENTS.mdsimple. - Arnés de benchmark: un runner que clona repositorios fijados a un commit, ejecuta
claude -pbajo ambas condiciones, corre una verificación oculta y registra tokens, costo, turnos y la traza completa de llamadas a herramientas como una línea JSON por corrida. - Reportes: cada cifra publicada — los READMEs, el sitio de documentación y la tabla de esta página — se genera a partir de esos archivos crudos. El CI falla si alguna se desfasa.
- Privacidad: no hay nada de código de red. Sin analíticas, sin reportes de errores, sin chequeo de actualizaciones.
Comprobalo en vez de creerme:
Cada corrida es una línea de JSONL en bench/results/, con el modelo, la versión de Claude Code, el commit de ThinWindow, los conteos de tokens crudos y la traza de herramientas. No se excluye nada: las corridas fallidas quedan en las tablas. Para correrlo contra tu propia cuenta:
node bench/run.mjs --condition baseline,thinwindow --reps 3 --model sonnet --dry-run
node bench/run.mjs --condition baseline,thinwindow --reps 3 --model sonnet --max-cost 10
node bench/report.mjs
Lo que los números no dicen:
El benchmark se publica a propósito con sus límites a la vista, porque una medición sin ellos es marketing:
- Es acotado. Ocho tareas, dos bibliotecas de parseo de argumentos de línea de comandos, tres modelos, en JavaScript y Python, y las reglas se ajustaron contra esas mismas tareas. Alcanza para mostrar una dirección, no para prometerle un porcentaje a nadie.
- La contabilidad de tokens es volátil. Las versiones de los modelos, los prompts del arnés, la tasa de aciertos de caché, las herramientas habilitadas, el tamaño del repositorio y la suerte del día pueden mover un resultado más que el efecto medido acá. Por eso las tablas muestran medianas y dispersión por tarea, y no un único promedio de titular.
- No todas las tareas mejoran. En Sonnet 5, tres de las ocho tareas salieron más caras con ThinWindow que sin él. Esas regresiones se publican en vez de descartarse, y son el camino más claro que queda hacia mejores números.
- Los resultados van a envejecer, y se van a volver a medir en lugar de dejarse ahí sin tocar.
Conclusión:
ThinWindow empezó como una herramienta personal para abaratar mis propias sesiones con agentes, y se publicó porque las mediciones parecían más útiles que la opinión detrás de ellas. El proyecto demuestra:
- Construir contra el modelo de costo real — contexto reenviado por turno — en lugar del intuitivo.
- Condicionar el comportamiento del agente en el límite de la llamada a la herramienta, mediante la API de hooks de Claude Code, con un diseño que falla en modo abierto y nunca puede bloquear una llamada.
- Publicar una misma base de código como plugin de Claude Code y como Agent Skill portable, para que las reglas sobrevivan a cualquier arnés en particular.
- Diseñar un benchmark de agentes reproducible: repositorios fijados, verificación oculta, corridas secuenciales, resultados crudos versionados y regresiones incluidas.
- Tratar cada número publicado como salida generada, con un CI que falla cuando la documentación se desfasa de los datos.
Etiquetas
Compartir